

Linux目錄明明很大卻算不出來?du別只看星號展開的檔案
網站目錄佔了不少空間,跑du -sh ./*卻只看到幾個小目錄?先別認定du算錯。在一般Bash設定下,星號展開不會包含名稱以點開頭的項目;像.cache、.git這些目錄,可能根本沒被交給du統計。 先看星號實際展開了什麼 到要檢查的目錄,先確認所在位置,再列出./*代表的路徑。下面只顯示位置與名稱,不會修改檔案。 pwd printf '%s\n' ./* 假設目錄裡有visible和.cache兩個子目錄,Bash未啟用dotglob時,這個星號通常只展開成./visible。接著執行du -sh -- ./*,du收到的也只有那個路徑。.cache沒有出現在結果中,不是du先讀取後把它排除,而是shell沒有把它列進參數。 不同shell或自訂設定可能改變展開結果;若星號沒有匹配到項目,顯示原樣或報錯也可能和設定有關。先看實際路徑,不要把某台主機的習慣當成所有Linux環境的固定行為。 要算整個目前目錄,就直接指定點 想知道目前目錄總共佔多少空間,不必把星號改成一長串隱藏檔案模式。直接把目前目錄.交給du: du -sh -- . -s彙總指定路徑,-h用容易閱讀的單位顯示。du會從這個目錄往下統計,名稱以點開頭的子目錄也在範圍內。輸出最後的點代表整個目前目錄,不是單獨一個普通檔案。 再找出哪一個子目錄較大 在提供GNU du的Linux環境,可把顯示層級限制在下一層。這條仍然以目前目錄為起點,而不是使用星號列出普通名稱。 du -h --max-depth=1 -- . 結果會列出第一層子目錄,以及最後的目前目錄總量;符合範圍的.cache也會顯示。--max-depth=1限制的是顯示深度,不代表只讀一層就能算完:子目錄裡的內容仍需要統計,大型目錄照樣可能花時間與I/O。 這個寫法不會替你把每個第一層普通檔案逐一列出。若某個大檔案直接放在目前目錄,總量會包含它,子目錄那幾行相加卻不一定等於總量。不要把這個差額全當成隱藏目錄。 用小例子對照兩種範圍 假設visible裡放一個4KiB檔案,.cache裡放一個1MiB檔案。一般Bash的./*只列visible,沿用它的du結果就不會反映那個1MiB隱藏檔案;改成du -sh -- .,總量會把兩邊都納入。再用上一節的層級顯示,就能看出.cache比visible大。 這裡的檔案大小只是示例,du通常顯示磁碟配置用量;目錄本身、檔案系統配置方式及工具的單位設定,都可能讓顯示值和檔案內容長度不同。重點是比較同一位置、同一工具下的統計範圍,而不是要求輸出剛好等於兩個數字相加。 數字還是對不上時 留意權限不足的錯誤,掃描期間檔案是否持續變動,以及目錄裡有沒有掛載其他檔案系統。上面的指令沒有要求停在同一檔案系統,不能直接拿它的總量和某一個掛載點的df數字畫等號。GNU選項也不保證適用於BusyBox或macOS的du。 找到大目錄後先確認用途和保留規則。快取、版本庫、上傳檔案或備份需要不同處理方式;名稱以點開頭不代表可以刪。這次先把統計範圍查清楚,再決定是否有需要安排清理。 參考資料 GNU Coreutils手冊:du統計與顯示深度 GNU Bash手冊:檔名展開與dotglob
Linux排程上一輪還沒跑完?用flock避免工作重疊
匯入資料每分鐘啟動一次,但某一輪花了兩分鐘,下一輪又開始寫同一批檔案。排程準時啟動,不代表上一輪已經結束。若工作不能重疊,可以用Linux的flock把同一項工作包起來:只有拿到鎖的那一輪才執行。 先決定第二輪應該等待,還是跳過。flock預設會等鎖;加上-n則立即回報沒拿到,不會替你排隊補跑。這是工作流程的選擇,不能把「沒有執行」當成「已完成」。 先在兩個終端看見同一把鎖 在自己的Linux測試環境執行下面這行,它會建立一個獨立暫存目錄,並印出路徑。把實際印出的路徑複製給兩個終端的demo_dir;兩邊必須指向同一個目錄,別各自再跑一次mktemp。 mktemp -d /tmp/flock-demo.XXXXXX 先在終端A啟動一個只等待10秒的虛構工作。把路徑換成剛才的實際結果,不要使用別人的鎖檔,也不要拿正式匯入工作來試。 demo_dir=/tmp/flock-demo.實際結果 flock -n -E 75 "$demo_dir/job.lock" \ bash -c 'printf "A started\n"; sleep 10; printf "A finished\n"' 看到A started後,在10秒內從終端B執行: demo_dir=/tmp/flock-demo.實際結果 if flock -n -E 75 "$demo_dir/job.lock" \ bash -c 'printf "B started\n"'; then printf 'B completed\n' else rc=$? printf 'B did not succeed, exit=%s\n' "$rc" fi A仍持鎖時,B不會印出B started,會得到退出碼75。等A finished出現後,再跑同一段B,這次才會印出B started與B completed。鎖檔還在不影響重跑;檔案存在與鎖正在被持有是兩件事。 把沒拿到鎖和工作失敗分開記錄 -E 75指定的是鎖衝突的退出碼。若已拿到鎖且成功啟動子命令,flock會傳回子命令的退出碼。因此退出碼75也可能是你的工作自己回傳的75;不能只看這個數字,就斷言另一輪正在執行。 套到真實工作前,核對工作本身的返回值規則。若約定保留75給鎖衝突,工作就不應用同一個值表示其他失敗;若無法約定,紀錄還要能分辨是否已進入工作。工作返回非零時要保留原因,別用|| true讓呼叫者一律看見成功。 下面刻意讓拿到鎖的工作退出7。請在A結束後單獨執行,結果應是7,並非75: demo_dir=/tmp/flock-demo.實際結果 if flock -n -E 75 "$demo_dir/job.lock" bash -c 'exit 7'; then printf 'work succeeded\n'...
Linux shell變數在子程序不見:assignment與export
在終端設了變數,接著啟動腳本卻讀不到,常見原因是你只做了shell變數賦值,沒有把它放進子程序的環境。assignment與export各有作用:前者讓目前shell保存一個值,後者把該變數標記為輸出,讓後續啟動的程序收到它。先分清誰設定、誰讀取,比反覆把值寫進不同設定檔更容易找到問題。 目前shell有值,子shell未必有 以下案例使用專屬變數WN_SAMPLE,避免改動PATH或其他既有設定。先unset清掉這個名字,建立目前shell的值,再啟動新的bash讀取。子shell的參數展開用單引號包住,確保它在子shell裡執行;若改用雙引號,外層shell可能先把值展開,輸出看似成功,實際並沒有證明子程序收到了環境變數。 unset WN_SAMPLE WN_SAMPLE=parent printf "parent-before=%s\n" "$WN_SAMPLE" bash -c 'printf "unexported-child=%s\n" "${WN_SAMPLE-unset}"' 在Ubuntu 24.04、GNU Bash 5.2.21的自有隔離案例中,目前shell輸出parent-before=parent,子shell輸出unexported-child=unset。這裡unset是取不到變數時由展開語法提供的文字,不是子shell真的建立了名為unset的值。新的bash沒有拿到尚未export的WN_SAMPLE,因此兩個結果可以同時成立。 export讓後續子程序收到環境值 export WN_SAMPLE bash -c 'printf "exported-child=%s\n" "$WN_SAMPLE"' 這次子shell輸出exported-child=parent,因為WN_SAMPLE已被標記輸出。你也可以用export WN_SAMPLE=parent一次設定並輸出,但不要把兩種寫法的差異誤認為字串值的差異。關鍵是export屬性,而不是變數剛好叫什麼名字。已經輸出的變數再賦新值,後續程序會收到新的值;已經啟動的程序則不是這次操作的接收對象。 程序啟動時收到一份環境,而不是持續連到父shell變數的共享欄位。父shell之後改值,不能因此推論先前啟動的服務已更新。若網站程式讀的是啟動時的環境,修改終端中的值與正式服務讀到的新值之間還有自己的啟動流程。本案例只啟動短生命週期的bash,沒有改服務設定、重啟程序或測試正式站。 子程序改值,不會回寫父shell bash -c 'WN_SAMPLE=child; printf "child-changed=%s\n" "$WN_SAMPLE"' printf "parent-after=%s\n" "$WN_SAMPLE" 隔離案例的輸出分別是child-changed=child、parent-after=parent。子shell可以改自己的變數,但它的修改不會回流成父shell的新值。export也不會改變這個方向:它負責提供啟動環境,不是雙向同步機制。如果腳本需要把計算結果交回呼叫者,必須另用輸出、檔案或你設計的通訊方式,而不是只在子shell裡賦值。 同樣地,子程序收到的環境不代表它會再次把所有新變數傳給更下一層程序。若在子shell裡建立了另一個未輸出的變數,仍需分清該子shell自己的變數與它輸出的環境。排查多層腳本時,每一層都看誰啟動誰、值在哪裡設定,以及該名字是否被export,不要把最外層設定成功當成所有層都一定收到。 只給一個指令的暫時值 WN_SAMPLE=temporary bash -c 'printf "one-command-child=%s\n" "$WN_SAMPLE"' printf "parent-final=%s\n" "$WN_SAMPLE" 這次one-command-child=temporary,但parent-final仍是parent。放在外部指令前面的賦值,可供該次指令使用,不必把父shell原值永久改成temporary。這很適合只想測一次程式對某個設定的反應。注意這裡接的是外部bash指令;shell特殊內建、函式或其他語法的環境與賦值規則不應一概套用。本篇只驗證所列的外部指令形式。 如果值含空白,仍要正確引用,例如WN_SAMPLE="two words" bash -c後面的指令。引用控制shell如何把文字分成參數,export控制變數是否進入環境,兩者處理不同問題。收到值卻因未引用而分裂成多個參數,與完全沒有收到環境值,是兩種不同故障。先印出限定變數的實際值與參數,再決定要修哪一層。 在真正啟動程式的位置檢查 互動終端、排程與服務可能由不同程序啟動。你在某個終端export成功,只能證明該shell之後啟動的子程序能收到值,不能保證另一個排程或服務也繼承同一份環境。先找出實際啟動鏈,再在自己的測試程序中讀取需要的名字。不要為了排查一個變數就把整份環境公開貼出,因為其他名字可能包含與本問題無關的資料。 Bash啟動檔也與登入、互動等模式有關。腳本用bash -c啟動與你開終端後手動操作不完全相同;不能假設某個互動啟動檔一定會被所有程序讀取。本篇用乾淨的專屬變數加明確賦值,讓結果來自assignment與export,而不是依賴使用者既有啟動檔。若自己的環境出現不同結果,先看是否有啟動檔或程式內部再次設定同名值。 不要把執行腳本與source混成同一件事 執行一支腳本通常由另一個shell程序處理,腳本裡改變自己的變數,不能直接改回呼叫它的父shell。Bash的source或點指令則是在目前shell環境中讀取檔案,作用範圍不同。若為了讓值留下來而把原本執行腳本改成source,檔案中的其他命令也會在目前shell生效,不能只把它當成export的另一種寫法。應先確認檔案就是設計成可被讀入的設定,再選擇這種方式。本例沒有讀入其他檔案,也沒有用source改父shell。 也要分清空字串與未設定。${WN_SAMPLE-unset}只有變數未設定時才用替代文字;若變數存在但值是空字串,輸出仍是空。另一種帶冒號的展開形式會把空值也納入替代條件,兩者不能在排查時隨意交換。若你的程式把空字串視為有效設定,就應保留這個差別。本案例先unset再賦非空字串,讓未輸出與已輸出的結果更容易辨認,沒有把所有空值處理策略套給應用程式。 最後,export清單只是目前shell的狀態。另開一個與它沒有父子啟動關係的終端,不會自動得到你剛剛修改的值。若需要長期固定設定,要放到實際啟動程序使用的設定來源,再按該環境的程序管理方式生效。這一步超出單次shell實驗的範圍;先確認傳遞機制,才決定適合自己的設定位置。 用小案例確認傳遞方向 完整案例按順序得到五個關鍵結果:未輸出的子shell取不到值、export後收到parent、子shell改成child、父shell仍保留parent、單次指令收到temporary而父shell最後仍是parent。所有操作在本地無網路隔離容器完成,容器已退出,沒有改系統全域設定。本案例版本是Bash 5.2.21,參考Bash文件來自官方5.2.37發行包;補丁版本不同已分開記錄。 遇到「腳本讀不到設定」時,可以先用這組小測試驗證你的啟動方式,再回到實際腳本。保留同一個專屬名字、明確的unset與限定輸出,容易看出值在哪一層消失。確定程序真的收到值後,才查程式是否使用另一個名字、是否有自己的預設值,或是否在啟動後把它覆蓋。這樣不必靠反覆修改全域設定檔猜原因。 參考資料GNU Bash 5.2.37官方發行包:Bash手冊POSIX:Shell Command LanguageLinux man-pages:environ,man7上游出版鏡像Linux man-pages:execve,man7上游出版鏡像POSIX:env
Linux curl遇到404仍回傳成功:傳輸成功與HTTP失敗怎麼分
排程用curl下載API資料,伺服器明明回傳404,後面的工作卻照常執行。先別急著把錯誤歸到shell:curl預設把「完成HTTP交換」視為成功,資源不存在則是HTTP回應裡的另一層結果。兩者分開看,才能決定程式該停下來,還是保留錯誤內容供查閱。 先分清退出碼與HTTP狀態碼 shell讀到的退出碼是本次curl程序的結果;HTTP狀態碼由伺服器放在回應中。成功連線、送出請求並收到完整404回應,可以同時得到HTTP 404與程序退出碼0。這不表示檔案存在,也不表示API處理了你要做的事。 反過來,DNS解析失敗或連線中斷時,curl也可能根本沒拿到HTTP回應。把所有非零退出碼都寫成「API回傳404」,會把網路問題與應用程式錯誤混在一起。診斷時至少保留退出碼、HTTP狀態,以及適合公開的錯誤內容;不要把憑證或完整敏感回應直接印到共用紀錄。 同一個404,三種選項的結果不同 下面的對照使用curl 8.21.0與自有隔離Python HTTP服務。服務的/missing固定回傳404和一小段JSON,/ok則回傳200。服務沒有對外開放連接埠,也沒有操作真實API;這個案例只用來確認命令行的錯誤處理。 default HTTP 404 exit 0 保留錯誤正文 --fail HTTP 404 exit 22 不輸出錯誤正文 --fail-with-body HTTP 404 exit 22 保留錯誤正文 --fail-with-body HTTP 200 exit 0 保留成功正文 若後面的步驟只看退出碼,預設命令就會放行404。加入--fail後,這次404變成退出碼22;加入--fail-with-body也得到22,但仍可讀到伺服器傳回的錯誤說明。兩個選項解決的是不同需求,並不是正文越少就一定越安全。 --fail-with-body從curl 7.76.0加入,舊機器先跑curl --version核對。沒有這個選項時,不要直接照抄後宣稱相同效果;可以先用--fail,或另行保存HTTP狀態再依服務契約判斷。不同系統的curl可能帶不同版本,不能只靠作業系統名稱猜測。 需要錯誤JSON時,用fail-with-body並立即保存退出碼 若要在自己的開發環境重現,可先啟動下面這個Python測試服務,再從另一個終端執行curl。它只監聽本機位址;不要把示範服務放到正式網站,也不要改成對外監聽來方便測試。執行時保持服務終端開著,結束後用Ctrl+C停止。 from http.server import BaseHTTPRequestHandler, HTTPServer class Demo(BaseHTTPRequestHandler): def do_GET(self): ok = self.path == "/ok" body = (b'{"ok":true}\n' if ok else b'{"error":"not found"}\n') self.send_response(200 if ok else 404) self.send_header("Content-Type", "application/json") self.send_header("Content-Length", str(len(body))) self.end_headers() self.wfile.write(body) HTTPServer(("127.0.0.1", 8080), Demo).serve_forever() 把程式存成demo.py,用python3 demo.py執行。若連接埠已被自己的其他工作占用,就同時修改服務與curl網址的連接埠,不要停止用途不明的程序。先請求/ok確認回應200,再改成/missing。這樣能分清服務未啟動的連線失敗,與服務正常回覆的404。 示範沒有驗證身分、資料庫或第三方服務,狀態由路徑直接決定。它適合檢查下載腳本對HTTP錯誤的分支,卻不能證明你的正式API一定使用相同錯誤格式。移到真實服務時,仍要查它的文件:有些API回傳JSON錯誤,有些回傳HTML,直接把後者交給JSON解析器只會產生另一個錯誤。 url="http://127.0.0.1:8080/missing" curl...
Linux awk用逗號切CSV欄位錯位:引號裡的逗號怎麼辦
把商品CSV交給awk -F,,第二欄本來應是Coffee, milk,結果只剩Coffee,後面的狀態也往後移。問題不是文字編碼,而是你用每個逗號切欄位,沒有把雙引號內的逗號當成內容。普通分隔文字與帶引用規則的CSV,不是同一種解析任務。 先用一筆含逗號的名稱重現,再改用真正理解CSV的解析器。不要先把逗號刪掉,或者把所有雙引號移除;那會改變商品名稱,也可能讓原本合法的資料變成另一份意思不同的檔案。 一個CSV欄位可以包含逗號 id,title,status 1,"Coffee, milk",ready 2,"She said ""Hi""",draft 這三行示範header與兩筆資料,每筆都應有三欄。第一個標題包含逗號,所以用雙引號括起來;第二個標題內的雙引號,用兩個連續雙引號表示。這不是多了一欄,而是CSV引用的內容表示方式。 RFC 4180描述常見的逗號、雙引號與換行規則,是這裡比較的格式依據。它不是宣稱所有叫CSV的檔案都使用相同方言;有些匯出會用分號、不同引用方式或額外編碼標記,仍要查真正產生檔案的工具約定。 awk -F只設定欄位分隔,不自動理解引用 把範例保存為example.csv,再查看欄數與第二欄。這個命令只讀取檔案,不改寫來源。 awk -F, '{ print NF, $2 }' example.csv 在隔離Ubuntu 24.04、mawk 1.3.4的實跑,header顯示三欄;Coffee那筆卻顯示四欄,第二欄只剩開頭引號與Coffee。She said那筆雖然仍是三欄,第二欄保留CSV用來轉義的引號,不是已還原的標題文字。 欄數偶爾對了,也不表示已正確解析。第二筆沒有逗號,所以簡單切分看不出錯位,卻仍沒有按引用規則還原內容。這就是只拿一筆沒有特殊字元的資料測試,很容易誤以為awk -F,已支援CSV的原因。 awk本身是有用的文字處理工具,這個例子的問題在你選的切分方式。當輸入確實是一種不允許引用或內含分隔符的簡單格式,固定分隔可以符合約定;如果檔案使用CSV引用,就不能用同一個假設解讀。 用Python csv.reader還原欄位 Python標準函式庫提供csv.reader。讀文字檔時設定newline空字串,讓CSV模組按自己的規則處理換行;編碼則依真實檔案約定指定。以下限定為UTF-8範例,不對未知來源自動猜編碼。 import csv with open('example.csv', newline='', encoding='utf-8') as f: for row in csv.reader(f): print(len(row), row[1]) 隔離Linux Python 3.12.14實跑,三行都得到三欄;兩筆標題分別還原為Coffee, milk與She said "Hi"。引號中的逗號仍在同一個標題,轉義雙引號也還原成一個字元。這份對照只使用合成資料,沒有操作正式商品或客戶名單。 你可以先將讀出的每一列印出來,比對欄數和內容,再逐步加入真正需要的匯入動作。讀取成功不代表欄位符合業務條件,id是否有效、狀態是否允許、重複資料如何處理,都應在解析之後另做驗證。 不要把一行必然當成一筆資料 帶引用的CSV還可能在同一個欄位內包含換行。若先用shell逐行讀取,再對每行做簡單拆分,就可能把一筆資料切成兩筆。本文的兩筆真實跑資料沒有這種換行,但格式規則允許它,解析器選擇應把這個條件考慮進來。 同理,先把原檔案丟給按行計算的工具,得到的行數不一定等於CSV資料筆數。需要報匯入幾筆時,應按解析後的記錄計算,並明確說明header是否計入。不能拿檔案多了幾行就判定多了幾件商品。 如果來源約定禁止欄位內換行,仍可以在解析後拒絕那種內容;這是一個檢查規則,而不是略過CSV解析的理由。先還原資料,再按契約檢查,較容易清楚指出是哪個欄位不符合需求。 GNU awk的CSV模式有版本條件 GNU awk從5.3版加入CSV欄位處理與--csv選項。這是特定實作的功能,不能看到系統有awk命令就直接使用。本文Ubuntu的awk是mawk,不是GNU awk,因此沒有拿--csv當成這台實跑環境的修正指令。 若你的系統確實安裝支援版本的gawk,可以按它的CSV模式文件評估。但不要把-F,和--csv混為同一功能,也不要只改成一段更長的正規表達式,就宣稱已處理任意引用與嵌入換行。先核版本、資料方言與實際邊界案例。 不需要為了這個小型匯入任務強制更換所有系統的awk。若環境已有符合要求的Python標準模組,使用它即可把解析責任寫清楚;若有既定的CSV匯入工具,也可沿用它,再驗證相同資料。工具選擇應符合你的部署環境與維護方式。 解析後先驗每列,再寫入 至少準備普通標題、含逗號標題、含雙引號標題,以及缺欄位的資料。前三種應還原成正確文字,缺欄位則應依契約報錯。不要在欄數不足時自動把最後一欄補成ready,否則原本壞掉的紀錄可能被當成可用商品。 如果匯出有header,可以核對欄位名稱與順序,再按名稱對應資料。某個工具把status移到第二欄時,只按$2固定位置處理就可能讀錯。這裡使用小型三欄例子,是為了看懂解析問題,不要求你把所有真實匯入都固定成這個順序。 保留原始檔案,在新的輸出或隔離資料庫驗證,避免直接覆寫來源。遇到錯誤時應能指出是編碼、引用結構、欄數還是業務值,而不是只有「匯入失敗」一行。清楚的分層能讓提供資料的人知道要改哪一部分。 如果要再輸出CSV,也用對應的writer處理引用,不要把每欄用逗號直接拼回去。讀取時成功保住標題內的逗號,輸出時卻沒有加引用,下一個工具仍會再切錯。輸入與輸出各自遵守同一份格式約定,資料才會在工具之間保持原意。 最後,把上面三行保存為回歸資料,每次更換匯出來源或解析工具後重新比對。你要確認的是欄位邊界與內容都正確,而不只是程式沒有拋錯。正式匯入的權限、交易與重複處理仍依自己的流程執行。 這份實跑把header也當一列印出,因此輸出三列、真正資料是兩筆。接到匯入程式時,應明確處理header,不要把id、title、status這三個名稱當成第一件商品。若來源沒有header,則依已約定的欄位順序讀取,不要自動跳過第一筆真資料。 參考資料 RFC 4180:CSV格式Python:csv模組mawk維護者手冊:欄位分隔POSIX:awk欄位GNU awk 5.3.2官方發行包手冊:CSV模式
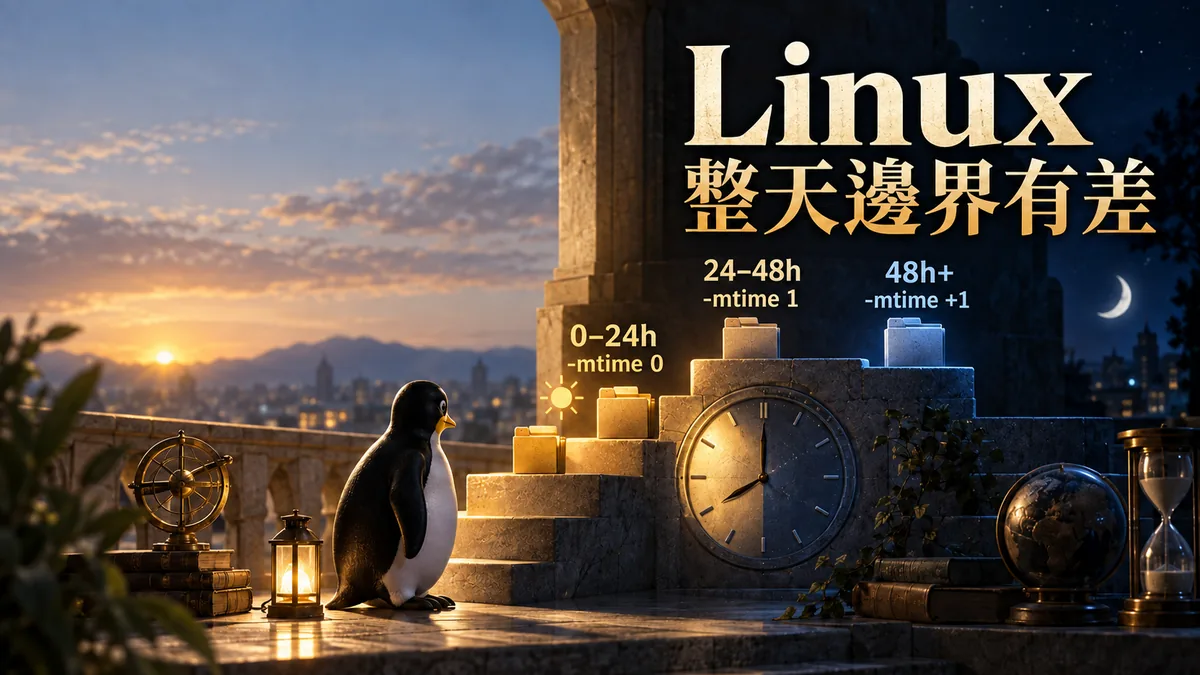
Linux find找一天前檔案不如預期:mtime怎麼算整天
想找一天前改過的檔案,寫了find -mtime +1,結果前天的有列出,昨天晚上的卻沒有。先分清你說的「一天前」是超過二十四小時,還是日曆上的昨天。GNU find的mtime天數按二十四小時區間計算,再把不足一個區間的部分捨去;加號也不是直接把條件改成超過二十四小時。 本文只列出示範檔案,不刪除或搬移資料。先用幾個已知修改時間驗證範圍,再把條件接回你的任務,避免把一個看似熟悉的天數直接套進清理腳本。 mtime看資料修改,不是檔案建立日期 mtime表示檔案資料最後修改時間。它與存取時間、檔案狀態變更時間不同,也不等於通用的建立日期。查備份或匯入紀錄前,先確認你要追的是內容被改,還是資料最初產生;選錯時間種類,即使天數邊界算對仍會得到不符合需求的名單。 這篇採GNU find的整數天數範例。假設執行時刻為基準,距離修改時間二十五小時,完整經過的二十四小時區間是1;四十七小時也仍是1;四十九小時則是2。不是四捨五入成最接近的一天。 不帶加減號,找的是一整段區間 find /your/test-folder -type f -mtime 1 -print 這表示修改時間距今至少二十四小時、未滿四十八小時的普通檔案。不是剛好二十四小時整,也不是所有一日以前的檔案。路徑只是你自己的測試目錄佔位,執行時應換成明確授權查看的目錄;不要直接照抄未知路徑。 如果想找最近二十四小時的過去修改,整數案例可用-mtime 0或-mtime -1。若檔案時間被設到未來,結果需要另行判斷,不能把這個範圍當成所有時間戳都正常的保證。最小測試只使用確實在過去的修改時間。 +1比較的是捨去小數後的大於1 -mtime +1在這個整數案例中,要完整區間數大於1,所以至少要到四十八小時。它不是「超過一個二十四小時就符合」。二十五與四十七小時的區間數仍是1,都不會通過這個比較。 相反地,-mtime -1要求區間數小於1,會選到未滿二十四小時的過去修改。符號是針對計算後的區間數比較,而不是把n改成一個自然語言的「n天前」標籤。這個小差別是清理名單少一天或多一天的常見原因。 建立五個時間,實際看三份名單 在新建的隔離示範目錄,建立距今二十三、二十五、四十七、四十九與七十三小時的五個空檔。touch -d是GNU touch的日期指定方式,會改修改時間,這些檔案只能是測試資料。 mkdir /tmp/mtime-case cd /tmp/mtime-case for age in 23 25 47 49 73; do touch -d "$age hours ago" "age-$age.txt" done find . -type f -mtime 1 -print find . -type f -mtime +1 -print find . -type f -mtime -1 -print 隔離Ubuntu 24.04的GNU findutils 4.9.0、GNU coreutils 9.4實跑:mtime 1列age-25.txt與age-47.txt;mtime +1列age-49.txt與age-73.txt;mtime -1只列age-23.txt。這三份名單和完整區間計算相符,不需要等待真檔案累積幾天才能核對。...
Linux檔名含空白就找不到:shell變數為何要加引號
上傳檔案明明存在,shell腳本卻說找不到。檔名叫site notes.txt,變數也印出正確路徑;真正送進命令時,空白把它拆成兩個參數。對一個已存好的檔案路徑,使用雙引號包住變數展開,才能讓整段值保持一個參數。 這個問題會出現在備份、匯入、圖片處理與部署腳本。不能要求所有使用者永遠不用空白檔名,也不宜靠刪掉空白讓錯誤暫時消失。先查命令收到幾個參數,再決定怎麼引用,較容易找出真正的展開問題。 變數值正確,不表示參數邊界正確 建立一個新的示範目錄,放入含空白的檔名,再把完整路徑存到變數。賦值這一行用單引號保存字面值;之後讀變數時,用雙引號讓變數展開但保留整段值。 mkdir -p /tmp/quote-demo printf 'one file\n' > '/tmp/quote-demo/site notes.txt' path='/tmp/quote-demo/site notes.txt' cat "$path" 這個目錄與檔案只供示範。執行前確認你自己的測試路徑沒有需要保留的內容,不要把正式檔案搬到這裡再覆寫。範例只是讀取資料,不處理檔名清理或重新命名。 寫成cat $path時,shell不是先把變數變成一個不可分割的路徑。一般未引用的變數展開,還可能經過分詞與檔名展開;預設分詞分隔包含空白、Tab與換行。命令因此收到/tmp/quote-demo/site與notes.txt,而不是原本那個檔名。 直接印出參數個數,比看echo更清楚 show() { printf 'argc=%s\n' "$#" printf '<%s>\n' "$@" } show $path show "$path" 在隔離Ubuntu 24.04、Bash 5.2.21的實跑,未引用得到argc=2,兩行分別是路徑前半與notes.txt;引用後得到argc=1,整個含空白的路徑在同一對尖括號中。這個小函式只查看參數,不修改檔案。 echo印出的外觀可能讓兩者很像:兩個參數之間也會用空白分隔,於是你看到的字串和原路徑相同。排查參數問題時,應印出個數與每項邊界,而不是只核對一整行文字。字串內容相同,傳入方式仍可能不同。 同一組案例中,cat $path回傳1,標準錯誤指出拆開後的路徑不存在;cat "$path"印出one file並回傳0。這證明差異發生在命令參數,而不是檔案讀取權限或原檔案已遺失。 雙引號和單引號有不同用途 雙引號中的$path仍會展開成變數值,但一般不再進行這個值的分詞與檔名展開。單引號中的$path則是字面的美元符號與名稱,不會讀變數。所以cat '$path'不會打開變數指向的檔案,而是嘗試找一個叫$path的檔名。 賦值時需要保存固定文字,可以用單引號;要把變數的值傳進命令,通常用雙引號。兩者不是誰比較安全就一律取代另一種,而是依你希望哪些字元被解釋來選。含單引號的字面內容則還需按shell引用規則處理,不要把任意外部文字直接貼進單引號模板。 這篇處理的是Bash命令列展開。PHP、Python或其他程式用參數陣列直接啟動程式時,不一定再經過shell分詞;相反地,把資料拼成一整段shell命令又會引入解釋規則。先確認呼叫途徑,不能只看到同一個路徑就假設引用方法相同。 星號也可能把一個值變成多個檔名 除了空白,變數裡的星號也需要想清楚。若pattern保存*.txt,未引用展開可能依當前目錄找到多個文字檔;引用後則把字面*.txt傳給程式。這不是哪一種結果永遠正確,而是你應知道自己要傳一個模式還是多個路徑。 pattern='*.txt' show $pattern show "$pattern" 本例在新的示範目錄只放a.txt與b.txt,未引用得到兩個檔名,引用得到一項*.txt。這個比較是在Bash預設行為下觀察,不把它推成每個shell選項、每個當前目錄都相同。若沒有匹配或開啟其他展開選項,結果應按你的環境另核。 當你已取得一個真實路徑,通常不希望它因星號、問號或空白再次變成搜尋模式。保持雙引號引用可以把資料當成一個參數;若目的真的是批次匹配,則應清楚設計模式來源與要處理的路徑,避免把使用者檔名誤當成規則。 多個路徑不要塞進一個空白字串 如果原本要處理兩個檔案,把兩條路徑用空白黏成files變數,再故意不引用去拆開,遇到任一檔名自帶空白就失去邊界。Bash中可使用陣列保存每個路徑,傳入時採用引用的陣列展開;這和一個路徑變數是不同需求。 files=('/tmp/quote-demo/site notes.txt' '/tmp/other.txt') show "${files[@]}" 這裡的第二個檔案不用存在,show只是展示兩項參數。真正讀取前仍要檢查來源與處理錯誤。陣列寫法是Bash功能,不應直接照抄到要求POSIX sh的腳本;選定執行shell後,再使用它支援的資料結構。 空值也有參數是否存在的差別 如果path是空字串,未引用展開可能完全沒有傳入參數;引用後則傳入一個內容為空的參數。本例另跑show確認,前者個數為零,後者為一。兩者對程式可能有不同含意,所以加引號不是替空值補出一個有效路徑,而是保持原本的資料邊界。需要拒絕空路徑時,應在呼叫前明確檢查,不能靠展開時剛好消失來處理。 引用保住邊界,其他條件仍要核對 加引號不會修復不存在的檔案、沒有讀取權限或錯誤的工作目錄。相對路徑還是依目前目錄解析;如果變數內容已經寫錯,它只會完整傳入那個錯誤值。先用這個最小比較確認分詞,再分別查檔案存在、權限與目錄。 檔名若以減號開頭,引用也不會自動取消程式的選項解釋。支援雙減號分隔的命令可按手冊使用--,或採清楚的路徑形式;不同程式是否接受這個分隔要核對,不能把shell引號當成所有選項問題的通用解法。 也不要改用eval讓路徑「重新解釋一次」。資料如果又被當成命令文字處理,會引入另一輪展開,反而更難保住原始邊界。對讀取一個檔案的需求,直接把引用的變數傳給cat就足夠,不需要增加命令字串層。 把空白檔名和含模式字元的值保存為測試資料,核對每個參數都符合預期,再接回真正的工具。若腳本可由多個入口呼叫,還要把相同檢查放在實際執行環境確認。這個案例只驗Bash本地參數與讀檔,不表示備份或部署已完成。 參考資料 GNU Bash 5.2官方發行包:展開與引用手冊POSIX:shell引用與分詞Bash上游manpage(man7鏡像)Linux:execve參數陣列POSIX:cat的檔案運算元
Linux grep沒找到就讓腳本中斷:分清退出碼1與2
部署檢查腳本要從紀錄找出ready,找到了就繼續,沒有找到就回報仍在等待。你加了set -e,希望命令出錯時停下來,卻發現紀錄沒有那一行,整支腳本就結束。檔案其實存在,grep也正常讀完;問題是把「沒有匹配」和「讀取失敗」當成了同一件事。 GNU grep通常用三種退出狀態表達結果:0代表選到了行,1代表沒有選到行,2代表發生錯誤。腳本若需要區分等待狀態和故障,就要讀這個狀態,不能只用有沒有輸出判斷。 先分清正常的沒有找到與真正錯誤 建立一個只有ready的檔案,再搜尋兩個詞和一個不存在的檔案。以下是小型示範檔案,不要把測試路徑換成正式紀錄後直接覆寫。 printf 'ready\n' > /tmp/status.log set +e grep 'ready' /tmp/status.log printf 'match=%s\n' "$?" grep 'missing' /tmp/status.log printf 'no_match=%s\n' "$?" grep 'ready' /tmp/missing-file printf 'file_error=%s\n' "$?" 在隔離Ubuntu 24.04、GNU grep 3.11與Bash 5.2.21中,三次狀態依序是0、1、2。第一個搜尋還印出ready;第二個沒有標準輸出;第三個把檔案不存在的訊息寫到標準錯誤。這裡的set +e只為了讓示範完整跑完,不是建議關掉整支正式腳本的錯誤處理。 退出碼和搜尋內容是兩個不同資料。若你用命令替換收集行,空字串不一定足以說明原因;找不到檔案也可能得到空的標準輸出。先記錄退出碼,再決定內容如何使用,錯誤訊息則應保留給維護者。 把可能沒有匹配的搜尋放進條件式 set -e的行為有上下文限制,不是每個非零結果都會立即退出。放在if測試位置的命令可以由你接手判斷,這正適合grep可能正常找不到的情況。先選一般grep,保留本例清楚的三種結果。 if grep 'ready' /tmp/status.log; then echo '已找到ready' else rc=$? case "$rc" in 1) echo '尚未找到ready' ;; *) printf '搜尋失敗:%s\n' "$rc" >&2 exit "$rc" ;; esac fi else第一行立即保存$?,因為它表示剛才grep的退出狀態。如果先echo一段提示,再讀$?,拿到的可能是echo成功的0。這種錯誤很隱蔽:維護者看得到失敗訊息,判斷分支卻以為前一個搜尋成功。 這裡把1視為業務上的「尚未出現」,其他非零值則向上回報。GNU版本的一般錯誤常是2,其他grep實作可能使用大於2的值,因此不要把未知的非零碼也塞進沒有找到。若你的流程規定找不到ready本身就是失敗,仍可以自行exit 1;那是流程規則,並非grep損壞。 不要用反向判斷後的狀態冒充原始結果 if ! grep看起來更短,卻會把命令成功與失敗反轉。如果進入這個分支後才讀$?,讀到的是反轉後的條件狀態,不能再用它分辨原始的1和2。需要保留錯誤分類時,使用上面的正向if與else保存原始狀態比較直接。 另一種常見寫法是grep後面接|| true,目的是讓set -e不要停。它同時吞掉「正常沒有匹配」和「無法讀取檔案」,下游只看到成功。當搜尋只是可有可無的顯示資訊,這可能是刻意選擇;但部署、備份或健康檢查若需要可靠分支,就不應把所有非零狀態都改成0。 本例另跑一支set -e腳本,直接搜尋missing後再echo after。結果退出1,after沒有執行;改成if測試後則印出conditional=1與continued。這個實跑只比較獨立命令與if位置,不推廣為所有函式、子shell或管線的完整規則。 只要布林結果時才考慮quiet模式...
Linux日誌輪替後tail沒更新:分清-f與-F
網站出錯時開著tail -f看日誌,畫面卻突然沒有新行;稍後打開app.log,又發現紀錄其實一直在增加。先別急著重啟網站。日誌可能已經輪替,眼前的tail還跟著舊檔,而程式已經寫進另一個同名新檔。GNU tail的-f與-F追蹤方式不同,選對方式才能繼續看新紀錄。 同一個檔名,不一定是同一個檔案 許多網站會把app.log改名成app.log.1,再建立新的app.log。路徑看起來沒變,但原來的檔案與新檔已經分開。GNU tail預設的-f以檔案描述符追蹤,檔案被改名後,仍會讀它原本開啟的那個檔案。這對需要繼續看原檔的情境有用,卻不是每位站長追最新網站日誌時想要的結果。 先核對tail所在的機器、容器與路徑。正式站可能把日誌寫在容器內或輸出到標準輸出,你在宿主機看到的同名檔案未必是網站目前使用的來源。不要只因為名稱是error.log,就認定它一定包含這個網站的新錯誤。讀取沒有權限或日誌根本沒有新增,與輪替造成追蹤舊檔是不同問題。 tail --version ls -li /path/to/app.log /path/to/app.log.1 追蹤新同名檔案,用GNU tail的-F 若你想追蹤的是這個路徑後來出現的新檔,可以用大寫-F。GNU tail把它定義成--follow=name與--retry的組合:依名稱追蹤,檔案暫時不存在或無法開啟時仍持續重試。這個選項適合改名舊檔、再建立新同名檔的輪替方式。 大小寫不能省略。-f與-F並不是同一個選項的兩種寫法;複製指令後要確認大寫F。下方-n 50表示開始時先顯示最後五十行,再繼續追蹤;你可以依排查需要調整行數。結束前台追蹤按Ctrl+C即可,不需要停止網站服務。 這裡討論的是GNU coreutils的tail,範例環境是Ubuntu 24.04與GNU coreutils 9.4。其他系統、BusyBox或精簡容器內的tail,支援的選項及行為可能不同。先用版本資訊與該環境的手冊核對,不要看到Linux就假設所有tail版本完全一樣。 tail -n 50 -F /path/to/app.log 用兩個終端,觀察輪替前後 想看清楚差異,可以在自己新建的測試目錄用普通文字檔重現,不需要動正式日誌。先建立app.log;在兩個終端進入同一個測試目錄,分別啟動-f與-F。為了只看啟動後新增的內容,兩邊都使用-n 0。最後在第三個終端依序追加文字、改名舊檔、建立新檔。 各步之間稍等一下,讓追蹤程序有時間讀到資料。輪替前的BEFORE_ROTATION應該兩邊都能看到。改名後,新的app.log寫入AFTER_ROTATION;-F會重新開啟這個路徑,繼續讀新檔。這個示例把輪替縮成兩條檔案操作指令,用來解釋檔案身份,不是要你在正式站手動改名正在使用的日誌。 mkdir tail-demo cd tail-demo printf "BOOT\n" > app.log # 終端一,在相同目錄 tail -n 0 -f app.log # 終端二,在相同目錄 tail -n 0 -F app.log # 終端三,按步驟執行並稍等 printf "BEFORE_ROTATION\n" >> app.log mv app.log app.log.1 printf "AFTER_ROTATION\n" > app.log 舊檔仍在新增,是另一個重要訊號 再往app.log.1寫一行LATE_OLD_FILE、往app.log寫一行LATE_NEW_FILE,你會更容易分清兩個追蹤目標。範例中-f看到舊檔後續新增的一行;-F則看到新檔後續新增的一行。它們都在工作,只是讀的檔案不同。 真實網站若輪替後仍把新訊息寫入舊檔,問題可能在產生日誌的程式還沒有重新開啟檔案。切換成-F不會替程式做這件事。需要核對應用程式或Web伺服器原有的輪替安排,由維護者按它的文件處理重新開啟日誌;不要為了看tail有沒有更新,臨時重啟所有服務。 可以先比較新舊檔案的修改時間、大小與近期內容,再確認產生日誌的程序是哪一個。若舊檔持續長大而新檔不動,就不應把「-F畫面沒新增」當成網站沒有事件。日誌來源與追蹤工具要分開查。 printf "LATE_OLD_FILE\n" >> app.log.1 printf "LATE_NEW_FILE\n" >> app.log...
Linux檔案權限看似正確卻開不了:逐層檢查目錄權限
檔案已經是644,網站程序卻讀不到,先看完整路徑上的目錄。Linux要找到檔案,通常得先穿過每一層目錄;檔案可讀,不代表執行帳號有權搜尋它的所有父目錄。 目錄的x代表搜尋或穿越,與普通檔案的執行權限不同。先確認實際使用者與群組,再逐層檢查,不要因看到Permission denied就把整棵網站目錄改成777。 先用發生錯誤的帳號查 你登入的帳號能讀,不代表PHP、Web伺服器或工作程序也能讀。先由有權限的維護者確認服務身分,並在相同身分下重現唯讀存取;不要用root讀成功就結束排查。 id namei -l /srv/site/private/readme.txt id列出目前使用者、主要群組與附加群組。namei -l會沿路徑列出各層擁有者、群組與權限,遇到符號連結也能看見解析過程。路徑是例子,換成真正失敗的檔案;沒有namei的環境,按當地工具與手冊逐層核對。 檔案r與目錄x,是不同的門 普通檔案的r允許讀取內容。目錄的r主要關係到列出其中的名稱,x則允許搜尋已知名稱和穿越該目錄;看得到檔名,不代表能進一步開啟檔案。 假設路徑是/srv/site/private/readme.txt,執行帳號通常需要對/srv、/srv/site與private等各層都有搜尋權限,最後還要對readme.txt有讀取權限。任一層拒絕搜尋,單改最後檔案的r也無法跨過去。 用非root帳號分開測兩種失敗 本文用專用Linux容器,檢查時使用UID與GID都為65534的非root身分。上層目錄為755,private的群組是nogroup,先設740,readme.txt則是644。 drwxr----- root nogroup private -rw-r--r-- root root readme.txt cat: Permission denied 這個帳號屬於nogroup,所以private使用群組的r--,缺少x。檔案雖可供其他使用者讀取,程序仍不能穿過private。只對該目錄增加群組x,變成750後,同一個帳號就能讀到檔案內容。 接著保留目錄750,把檔案改成root擁有的600,又讀取失敗。此時目錄都可穿越,缺的是最後檔案的r;把這個專用檔案的群組設為nogroup並給群組讀取,變成640,才再次成功。 條件 cat結束碼 目錄740,檔案644 1:缺目錄搜尋權限 目錄750,檔案644 0:讀取成功 目錄750,root檔案600 1:缺檔案讀取權限 目錄750,nogroup檔案640 0:讀取成功 這些權限只用於隔離案例,nogroup不是所有網站應使用的服務群組。正式環境要按真正的服務帳號、資料敏感性與存取範圍設計,不是照抄750或640就算正確。 案例再把目錄的群組r移除,只留搜尋x,目錄變成710,檔案仍為nogroup可讀的640。同一個帳號用ls列目錄失敗,卻仍能依已知完整名稱讀取readme.txt。這進一步分開「列出名稱」與「找到已知檔案」兩種能力。 不過,不能列目錄不等於內容已保密。知道檔名的使用者若有搜尋與檔案讀取權限,仍可能取得內容。私人設定需要按真正的讀取對象保護,不能只靠藏住目錄列表。 先選對權限類別,再看有沒有那個位元 一般模式位元會依檔案擁有者、群組與其他使用者判斷適用類別。不要看到others有r,就認為任何帳號一定可讀;若帳號屬於適用的群組,群組那一段才是要看的權限,不會把三段全部相加成一份。 服務程序的附加群組也要核對。修改帳號群組後,已在執行的程序可能仍保留原本群組身分,需要依服務流程讓它重新取得身分;不能只看帳號資料已更新,就認定現有工作程序已經變了。 同一個檔案在容器內外的UID和GID也可能呈現不同名稱。比對數字身分與掛載條件,避免只因兩邊都叫www-data就推成同一個權限主體。 修正要落在真正擋住的那一層 先保存各層擁有者、群組與模式,再與服務需求核對。若只需要讀一份設定,就讓適當的服務群組能穿越必要目錄並讀該檔;不需要順手開放整個目錄的寫入或執行權限。 隔離案例使用的是群組搜尋與讀取兩個分開的改動: chmod g+x /專用測試目錄/private chmod g+r /專用測試目錄/private/readme.txt 這些命令以群組歸屬已確認為前提,只在自己的測試資產操作。正式檔案若屬於別的群組,新增g+r可能讓不該讀的使用者取得內容,也可能仍然沒有幫到服務帳號。 不要直接chmod -R 777,也不要替所有普通檔案加x。目錄需要搜尋權限,文字設定檔通常只需讀取;遞迴套一個數字,容易把不同用途的資產都放寬到不必要的範圍。 符號連結把你帶去哪,也要查清楚 readme.txt若是符號連結,還要核對目標所在目錄。原路徑看起來都有x,目標卻在另一個private目錄,仍可能被那一層擋住。namei的路徑展開能提供線索,不要只看連結本身常見的rwx字樣。 路徑的相對起點也要正確。服務工作目錄與手動終端機不同時,可能查到另一個檔案;先確認真正解析的目標,再談權限。檔案不存在、檔名大小寫不符與存取被拒絕,應保留不同錯誤,不要全部當成644問題。 模式正確,仍可能有其他限制 ACL可以增加更細的使用者或群組規則,還有mask會影響有效權限。若系統使用ACL,以有權限的工具查看有效設定;單看ls -l或mode,不一定涵蓋全部存取判斷。 SELinux、AppArmor、服務沙箱與容器掛載限制,也可能另外拒絕讀取。這時核對相關拒絕紀錄與既有政策,由負責人處理;不要為了驗證就停用全機的安全機制。 修完仍用同一個身分讀一次 讓發生錯誤的程序身分重新讀取,確認每層目錄可搜尋、最後檔案可讀,再驗網站實際功能。命令列cat成功只確認檔案內容可取得,不代表應用設定、路由與解析也正確。 最後確認權限沒有意外擴到其他使用者,保留原值與本次修改範圍。若仍被拒絕,沿路徑找下一個限制,不要把一次局部修改擴成全站權限重設。 參考資料Linux:逐層路徑搜尋與EACCESutil-linux namei:路徑展開與權限GNU chmod:權限類別與目錄搜尋位元Linux:ACL存取判斷與maskLinux:程序使用者與群組身分
Linux排程手動成功卻沒跑:環境變數與工作目錄怎麼查
終端機手動執行成功,排程卻沒有產出檔案,先別不停重加同一條cron。互動式shell裡已有的PATH、變數與目前目錄,排程執行時未必相同;命令可能根本找不到,或已開始執行卻讀錯相對路徑。 先區分「排程沒有啟動」和「命令啟動後失敗」。本文處理後者常見的環境差異,用受限環境逐項重現;排程時間、daemon與實際觸發紀錄仍要另外核對,不能拿一次手動成功替代。 先記下失敗時用哪個使用者、哪條命令 保存完整命令、執行身分與錯誤輸出。使用者自己的crontab、系統crontab與其他排程器,不一定使用同一個帳號或相同格式。不要把自己登入後的成功結果,直接當成網站服務帳號也能讀寫。 在有權限的環境查看該帳號的排程與既有執行紀錄,確認命令真的開始過。沒有產出檔案,不等於沒有啟動;命令找不到、設定讀不到、輸出目錄不能寫,都可能在很早的步驟退出。 把互動環境收窄,找到第一個差異 env -i讓命令從空的環境開始,再明確提供需要的變數。這不是完整複製所有cron實作,而是用來排除「因為終端機碰巧已有設定才成功」的條件。 env -i PATH=/usr/bin:/bin TASK_MODE=demo \ /bin/sh /srv/site/job.sh 路徑與TASK_MODE是例子,要換成自己的腳本與非敏感設定。不要把正式密碼、Token或完整環境變數清單貼到公開日誌;只記排查所需的安全欄位,例如工作目錄、命令位置與結束碼。 本文的專用容器有一個報表helper,放在自己的tools目錄;它需要TASK_MODE=demo,並讀取目前目錄的config.txt。先在site目錄提供完整PATH與變數,結果成功,再只改一個條件。 條件 結果 完整PATH+site目錄+demo 成功,結束碼0 PATH不含tools 找不到helper,結束碼127 工作目錄改成other 找不到config.txt,結束碼1 沒有TASK_MODE 模式檢查失敗,結束碼2 明確路徑與目錄的wrapper 成功,結束碼0 這些是隔離腳本的實際結果,碼2來自本文helper自己的檢查,不是所有程式都用2表示環境變數缺失。案例沒有安裝cron,也沒有等待定時觸發;它驗證的是受限環境中命令如何失敗與恢復。 PATH影響找程式,不決定讀檔目錄 PATH用來尋找未寫完整路徑的可執行命令。你在終端機能呼叫node、php或自建helper,可能因登入設定已把它加入PATH。排程不一定讀取相同的啟動檔,也不會自動取得你的alias或shell函式。 先用command -v核對實際程式位置,再確認執行版本。需要固定某個runtime時,使用已核對的絕對路徑,或在自己的wrapper明確安排PATH;不要把互動式shell整份設定無差別source進排程。 command -v php command -v node pwd 找到程式不表示相對設定檔也找得到。config.txt、./output與相對日誌路徑,通常由目前工作目錄解析;腳本放在/srv/site,不代表執行時就自動在/srv/site。 把工作目錄與必要設定寫清楚 可以讓專用wrapper先切到確定的目錄,失敗就停止,再以絕對路徑呼叫工具。下列片段示範這個責任分配,不包含排程安裝: #!/bin/sh cd /srv/site || exit 1 TASK_MODE=demo /srv/site/tools/wn-report-helper 不要省略cd失敗的處理,否則目錄不存在時,腳本可能繼續在另一個位置工作。設定檔也可以改用明確絕對路徑,但要讓維護者知道由哪個位置讀取,避免一半相對、一半絕對而難以追查。 需要的變數由應用自己的設定方式提供。互動shell裡只是定義而沒有export的變數,不一定傳給子程序;即使傳給了手動執行,也不會因此永久寫進排程環境。先核實來源,不要為了成功而把所有私人設定複製過去。 相對路徑的影響不只在讀取。若腳本寫入./output,換一個工作目錄可能把產物寫到別處,畫面上就像沒有完成。先記下實際輸出位置,確認它是在預期目錄;不要為了找到檔案就用全機搜尋暴露其他資料。 檔案換成絕對路徑後,也要確認它確實是目前使用的版本。部署把current連結換到新目錄,排程卻仍指向舊release的腳本,可能一直跑舊設定;保存命令與實際解析路徑,才知道測的是否同一份程式。 shell不同,也可能改變結果 cron通常使用設定的SHELL執行命令;此處引用的Cronie手冊預設為/bin/sh。若腳本用了Bash專用語法,就要明確安排適合的解譯器,不要在終端機用Bash測過,排程卻用sh呼叫同一段內容。 直接執行腳本還受執行權限、shebang與掛載選項影響。本文第一次測試的tmpfs預設禁止執行,完整PATH也得到Permission denied;在自己的隔離掛載允許執行後,才分離出PATH與目錄差異。正式環境看到相同錯誤,應先核對限制用途,不要直接放寬整個掛載點。 排程命令還有自己的解析規則。例如Cronie會處理未跳脫的百分比符號,終端機裡可用的date格式字串,原樣貼到crontab不一定相同。複雜內容放進有版本紀錄的腳本,通常比把一大串命令擠在排程欄位裡更容易維護。 讓輸出能回答「失敗在哪一步」 把標準輸出與錯誤輸出寫到已存在、且執行帳號可寫的專用日誌位置。輸出重新導向由shell先處理;日誌目錄不存在或不能寫,命令甚至可能還沒開始就退出。 記錄開始時間、安全的工作目錄、結束碼與短錯誤即可,不要每次把env全列出來。保留原排程與腳本版本,先在自有測試範圍調整一項,再用同一個帳號和受限環境比較。 命令條件修好後,再驗真正的排程 受限環境成功,只證明這個命令具備所需條件。接著在真正到期時間核對排程器紀錄、腳本開始與完成,以及預期產物。daemon未運作、時間或時區不符、排程未載入,仍是另外的問題。 不要用反覆手動執行掩蓋沒有定時觸發的狀況。也別為了測試直接增加正式備份或資料寫入的頻率;先確認任務是否可重複、是否會重疊與產生副作用。環境、執行與產物分開核實,維護者才能知道真正修好了哪一段。 參考資料Cronie crontab手冊:環境、shell與命令解析GNU env:空環境與明確變數Linux:工作目錄與chdirLinux:執行檔、解譯器與noexec限制
- 1
- 2