

AI 生成的網頁可以直接上線嗎?表單、手機版與 SEO 檢查
AI 生成網站後,先確認表單真正收件、失敗提示、手機操作,以及 noindex 和 canonical 是否仍指向測試環境。
AI 建站平台與 WordPress 怎麼選?從費用、SEO 到後續維護一次比較
AI 建站平台與 WordPress 該怎麼選?比較代管方式、功能擴充、續約費用、SEO/AI 搜尋與搬站限制,依公司官網、內容網站及會員需求判斷。
robots.txt封鎖了,為什麼網頁還出現在Google?
你在robots.txt加了Disallow,Google搜尋卻仍出現那個網址。先別急著把規則寫得更嚴:robots.txt控制的是爬取,並不是把網址從搜尋結果中刪除。如果你的目的是「頁面可以公開瀏覽,但不要顯示在Google」,通常要處理的是noindex,而且Google必須能讀到它。 先分清:不讓爬取,還是不讓搜尋顯示? 依 Google的robots.txt說明,即使Google不能爬取網頁,仍可能從其他頁面的連結得知網址,再把網址顯示於搜尋結果。封鎖成功與搜尋結果仍有網址,可以同時發生。 noindex則告訴支援這項規則的搜尋引擎,不要將內容編入索引。對Google來說,它需要先爬取頁面,讀到HTML的meta標記或HTTP回應標頭,才能處理這個要求。若同一網址又被robots.txt封鎖,Google就可能看不到你加的noindex。 還有一個容易混淆的需求:如果頁面含有訂單、客戶資料或內部文件,你需要的是登入驗證與權限控制。robots.txt與noindex都不是保密機制;不要為了讓Google讀到noindex,就解除敏感內容的存取保護。 用公開篩選頁看兩種設定的差別 假設網站有一個任何人都能開啟的商品篩選頁,路徑是/filter/red/。它可以供訪客使用,但你不想讓這個特定頁面出現在Google。以下是設定示例,路徑應換成你自己的頁面;不是要求把全站篩選頁一律排除。 如果robots.txt寫著: User-agent: * Disallow: /filter/red/ 同時又在該頁HTML的<head>加入: <meta name="robots" content="noindex"> 這兩項不是加倍保險。對遵守封鎖規則的Googlebot而言,它先被擋在頁面外,就無法讀到裡面的noindex。若你的目標確實是不顯示這個公開頁面,應保留noindex,並讓該網址可被爬取;調整前要核對所有匹配它的robots規則,避免只刪一行卻仍被其他規則封鎖,也不要解除不相關路徑的封鎖。 HTML頁面可採上面的meta標記;PDF等非HTML資源,也可由伺服器回應 X-Robots-Tag: noindex。這是 Google支援的兩種noindex方式。不要把Noindex:寫進robots.txt,Google不支援這種寫法。 改好設定後,怎麼知道Google真的處理了? 先檢查「設定有送出」,再檢查「Google已讀到」,最後才看搜尋結果是否改變。 用瀏覽器或HTTP工具查看目標網址的實際回應。meta應在HTML的head中;若用X-Robots-Tag,檢查的是HTTP標頭。外掛畫面勾選了noindex,不代表訪客與爬蟲收到的頁面一定如此。 有該網站Search Console權限時,使用網址檢查的即時測試,確認Google能否存取頁面,以及它收到的HTML或索引規則。這是在查當下可讀的設定,不代表Google索引已立即更新。 再看網址檢查中的索引資料與網頁索引報表,留意最近爬取時間和noindex排除狀態。Google需重新爬取才能處理新增規則,不能用自己刷新搜尋結果幾次,就判定設定無效或已永久移除。 若急需移除已顯示的網址,可查看 Google的移除資訊說明。暫時移除工具不是永久處理,仍需用適合該內容的方式控制索引或存取。敏感資料應先處理存取權限與內容暴露,再處理搜尋結果,不能只等noindex生效。 資料核對:2026年10月2日。範例說明設定邏輯,實際網址的爬取與索引狀態應以你的網站回應及Search Console資料為準。 參考資料 Google:robots.txt簡介與指南 Google:使用noindex禁止建立索引 Google:控管您在搜尋分享的內容 Google:移除網站資訊
改了meta description,搜尋摘要為什麼還沒變?
把文章摘要改得更清楚,搜尋結果卻還是舊句子。先別每天重寫一次:後台儲存、前台輸出、搜尋引擎重新抓取,以及最後選哪段文字,是不同階段。先看訪客拿到的HTML用未登入的瀏覽器打開正式文章,查看原始碼,搜尋name="description"。確認它包含你剛儲存的內容,而不是登入預覽、快取舊頁,或另一個語言版本。如果找出兩個description,先記下各自內容,查主題與SEO外掛誰在輸出;不要只看到其中一個正確,就說問題已排除。例如本站的srcset與currentSrc文章,頁面原始碼同時有主題摘錄與SEO摘要。查看時要找出全部description,再決定該由主題還是SEO外掛輸出,避免兩邊各寫一份。Google不一定照抄你寫的摘要Google會依搜尋詞從正文選出相關段落,也可能使用meta description。同一個頁面在不同查詢下出現不同摘要,不一定是你的設定沒儲存。假設一篇文章介紹模板安裝,description概括安裝條件,讀者卻搜尋某個具體錯誤。搜尋摘要可能改用正文的錯誤處理段落。因此摘要要準確,正文也要直接回答讀者會搜尋的問題。更新一次,再核對正確網址先讓摘要準確交代本文解決什麼問題,別塞滿近義關鍵詞。核對公開網址、canonical及正文一致後,有該網站Search Console權限的人可使用網址檢查要求重新抓取;請求不保證立即抓取、立即換摘要或提升排名,也不需要反覆提交同一個網址。接著記錄查詢詞、看到的URL與摘要內容,再與前台HTML比較。如果搜尋結果仍指向另一個網址,先處理網址問題;前台已更新而搜尋摘要不同,不能單靠這點判定SEO外掛壞了。參考資料Google:搜尋摘要 Google:要求重新抓取資料核對:2026年10月4日。文件及頁面內容可能更新。
分類第2頁的canonical,不該照抄第1頁
分類第2頁放的是另一批文章,canonical卻還指向第1頁。這和替同一篇文章選標準網址不同:兩頁內容不一樣,不能只因第1頁比較重要,就把每一頁都當它的副本。把兩頁一起打開,比單看標籤更有用先從網站的「下一頁」連結進入第2頁,確認URL確實改變、文章清單也不同。再查看原始碼中的<link rel="canonical">:第1頁和第2頁各用了哪個完整網址?有沒有重複輸出多個canonical?本站精品教程的第1頁是/category/tutorial/,第2頁是/category/tutorial/page/2/。這兩個頁面各自輸出對應自己的canonical,可用來對照檢查方式。這個HTML結果不代表Google已採用它們,也不證明所有分類都相同。真正的分頁,要有可到達的下一頁Google對分頁清單的建議,是每頁使用自己的網址及canonical,而不是全部標成第1頁。下一頁也應有真正的<a href="…">連結;單靠按鈕載入、URL只變#page2,不是同一回事。找到只有「載入更多」的版型時,先確認它有沒有另外提供可直接開啟的分頁URL。不要看到按鈕能動,就推論搜尋引擎已讀到後面的內容。排序與篩選,不要混成分頁規則同一份清單改成按人氣排序,或加了一個篩選參數,可能產生別的URL策略。先分清「下一批內容」與「同一批內容重新排序」,再查索引設定。更改前保留現有輸出,在測試站核兩頁;別為了修一個canonical就把分類第2頁全設成noindex。想先分清轉址與標準網址,可看canonical與301的選法。此處只檢查頁面輸出,不承諾收錄或排名改變。參考資料Google:分頁與漸進載入 Google:標準網址資料核對:2026年10月4日。文件及頁面內容可能更新。
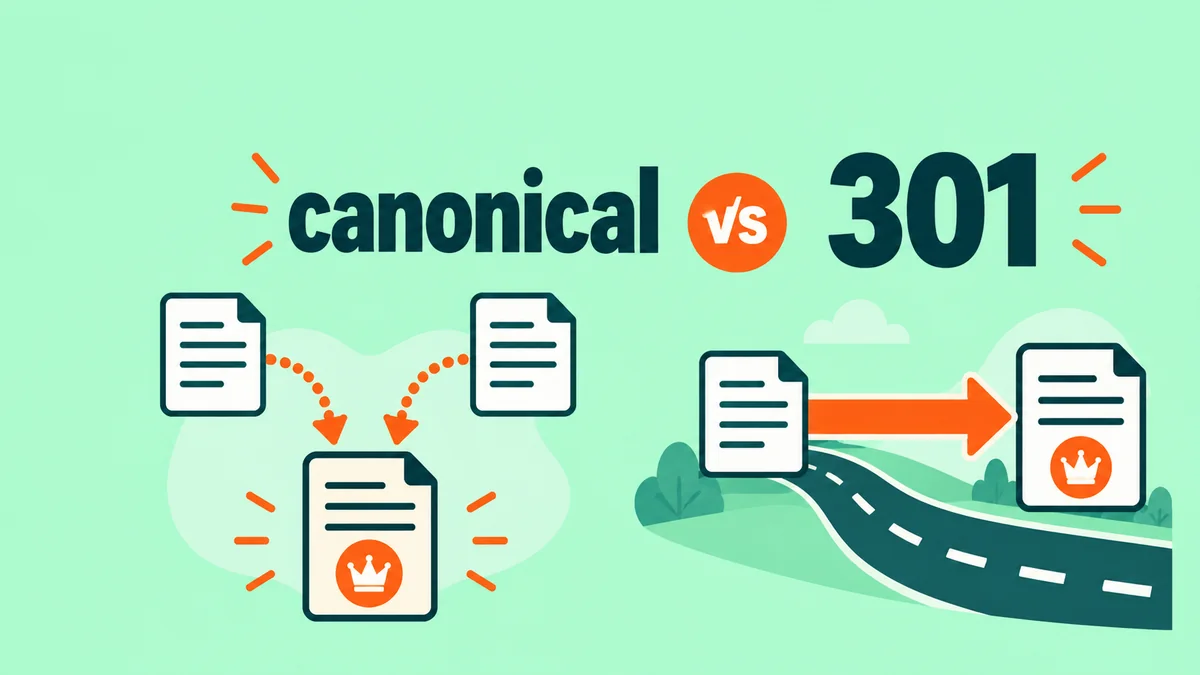
canonical和301怎麼選?先問舊網址要不要繼續能開
同一篇模板介紹有兩個網址,是加canonical就好,還是要做301?先問一件事:訪客開啟舊網址時,應該留在那一頁,還是直接去新網址?兩種設定處理的問題不同。保留頁面與把訪客轉走,不是一回事rel="canonical"告訴搜尋引擎,你希望哪個網址代表一組重複或非常相近的內容。它不會替訪客跳頁,搜尋引擎也不保證一定採用這個選擇。如果舊文章已永久搬到新網址,訪客不再需要看舊頁,301回應可把瀏覽器引導到Location指定的目標。目標應是對應的新內容,不要把所有舊文章都轉到首頁。用三個地址看差異假設/guide是主要頁,/guide?view=print仍需供訪客使用,/old-guide則已停用。前兩頁內容相近,可在需要整合的頁面表達主要網址:<link rel="canonical" href="https://example.com/guide">這是放在HTML的<head>裡,不是貼在正文。停用的舊網址則由伺服器回應:HTTP/1.1 301 Moved Permanently Location: https://example.com/guide在對應的HTTP例子裡,保留頁回200且含canonical,瀏覽器仍留在原網址;舊頁回301,瀏覽器才開啟目標。這能確認回應與跳轉,不能證明Google已抓取或已選中主要頁。先查目標,再改設定先記錄目前網址、回應與設定,確認目標能正常開啟、內容真是對應頁,也沒有反向轉回來。需要保留的相近頁面,用一致的canonical與站內連結表達偏好;已搬走的舊頁,安排直達新頁的重導,避免多次跳轉。不要把不相干的文章硬指到同一個主要網址。重導通常在主機、程式或既有外掛入口設定,不是複製一段正文程式就會生效。先在有備份的測試環境核對,失敗時還原本次規則;正式修改後再查URL和回應。如果還有robots封鎖或noindex,請另外核對爬取與索引的差別,別用它們取代canonical的用途。參考資料Google:主要網址與重複內容 MDN:301回應資料核對:2026年10月4日。文件與瀏覽器行為可能更新。