

AI 建站平台與 WordPress 怎麼選?從費用、SEO 到後續維護一次比較
AI 建站平台與 WordPress 該怎麼選?比較代管方式、功能擴充、續約費用、SEO/AI 搜尋與搬站限制,依公司官網、內容網站及會員需求判斷。
Node.js Brotli 漏洞已遭利用:受影響版本與站長更新重點
Brotli 漏洞 CVE-2026-111497 已有遭利用通報。核對 Node.js 22、24、26 的修補版本,了解自架網站、容器與 Vercel 專案應如何更新及重新部署。
LiteLLM 1.107.0 供應鏈事件:使用 AI 閘道的網站先核對部署版本
LiteLLM 在 2026 年 10 月 21 日通報發布管線遭入侵,惡意內容經由 1.107.0 套件與部分官方容器映像散布。
Next.js 10 月緊急安全更新:兩項 RCE 與 Server Actions 阻斷服務
Next.js 在 2026 年 10 月 14 日發布 16.4.1 與 15.5.28 安全更新,處理兩項嚴重遠端程式碼執行問題及一項高風險阻斷服務問題。
網址中的加號變空白:用URLSearchParams保留C++
搜尋框輸入「C++」,結果頁卻顯示「C 」。網址看起來也有兩個加號,為什麼程式讀出來就變成空白?問題常出在把使用者的值直接接進 query string:URLSearchParams解析這類查詢參數時,會把原始加號解讀成空白。 保留真正的加號,做法是把原始值交給URLSearchParams,由它負責編碼。不要先手動拼網址,也不要先encodeURIComponent再append。這兩種處理順序,會讓加號消失或讓百分號被編碼第二次。 同樣是C++,傳入方式決定結果 下面的例子可在瀏覽器Console或支援URLSearchParams的Node.js執行。第一段直接把查詢字串交給建構子,兩個加號被解析為兩個空白;第二段把值當成資料加入,序列化時才把加號變成%2B。 const broken = new URLSearchParams('q=C++'); console.log(JSON.stringify(broken.get('q'))); // "C " const params = new URLSearchParams(); params.append('q', 'C++'); console.log(params.toString()); // q=C%2B%2B console.log(params.get('q')); // C++ 這不是JavaScript把所有加號都改掉,也不是網址任何位置都遵守同一條規則。這裡談的是URLSearchParams採用的application/x-www-form-urlencoded查詢參數解析與序列化。真正的空白序列化為加號,真正的加號則需要百分比編碼,兩者才能分開。 若你已經拿到一段完整query string,建構子會把它當成已編碼的資料解析。如果你手上拿的是使用者輸入、資料庫值或程式算出的文字,就應把它當成原始值交給append或set。先辨認現在拿到的是哪一層,才不會解碼或編碼兩次。 建立網址時,讓URL管理路徑與查詢參數 站內搜尋可以先建立URL,再使用searchParams設定值。這樣遇到加號、空白、&或中文時,不必自己判斷哪些字元會切開下一個參數。下例用示範網址,不會發出網路請求。 const url = new URL('https://example.com/search'); url.searchParams.set('q', 'C++ & template'); url.searchParams.set('page', '1'); console.log(url.search); // ?q=C%2B%2B+%26+template&page=1 const received = new URL(url.href); console.log(received.searchParams.get('q')); // C++ & template 畫面顯示查詢內容時,使用解析後的值,例如input.value或textContent。不要把它直接塞進innerHTML;正確編碼網址,並沒有讓輸入內容變成可安全執行的HTML。網址組裝、HTML顯示與後端搜尋,是不同的處理位置,應各自使用合適的方法。 例子中的page是字串,不代表它已經成為有效頁碼。後端仍要檢查是否為允許範圍的整數,搜尋詞也要按產品需求限制長度。URLSearchParams負責結構與編碼,沒有替你完成資料驗證或存取權限檢查。 不要把encodeURIComponent結果再當原始值加入 常見修法是先把C++變成C%2B%2B,再交給append。這時URLSearchParams收到的原始資料已包含百分號,會把百分號編碼成%25,結果多出一層。接收端解析一次後,得到的是帶有%2B的文字,並不是原本的C++。 const twice = new URLSearchParams(); twice.set('q', encodeURIComponent('C++')); console.log(twice.toString()); // q=C%252B%252B console.log(twice.get('q')); // C%2B%2B encodeURIComponent本身有它的用途,但不要把它和URLSearchParams疊在同一個值上。當舊程式已經明確手動建立某個URL元件時,可以依該元件規則使用編碼;若改成URLSearchParams管理query,就讓它接收原始鍵名與值。把這個交接位置寫清楚,比在結果上不斷replace更容易維護。 同樣地,get已經回傳解析後的值,通常不應再decodeURIComponent一次。例如使用者本來搜尋字面文字「%2B」,解析一次正好保留這三個字元;再解碼就會把它變成加號,改掉原意。不要為了修一個案例,讓另一類搜尋詞出錯。 同名參數要先決定是否允許多個值 append會新增一項,同名鍵可以重複。set則設定該鍵的值,並移除該鍵其他既有項目。若篩選器允許多個分類,重複鍵可能正是你要的結構;單一搜尋詞則通常用set較清楚。讀取時get只取第一項,要取得全部才用getAll。 const...
下載檔名亂碼怎麼查:核Content-Disposition與UTF-8
網站上的下載連結寫「模板檢查表」,存到電腦後卻變成一串百分比編碼,或只剩download.csv。先別重新壓縮整包檔案:瀏覽器採用的檔名,可能來自下載回應的Content-Disposition,與頁面上的連結文字不同。 這篇處理下載檔名與UTF-8編碼。檔案能否下載、會員是否有權限,則屬於另外的功能;檔名顯示正常,也不能證明下載內容正確。 先分清檔名與檔案內容 下載後,先看錯的是「名稱」還是「打開後的文字」。CSV內中文字亂碼,可能要查檔案實際位元組與開啟軟體;檔案內容正常、名稱卻奇怪,則先查回應標頭。不要把CSV內容加了UTF-8設定,就認定檔名一定跟著修好。 另外記下來源網址與瀏覽器。下載可能經過重新導向,真正送出檔案的是最後一個回應;查看第一個入口的標頭,未必看得到檔名設定。頁面上的下載按鈕文字,也不等於伺服器建議的名稱。 在最後一個回應找Content-Disposition 開啟瀏覽器開發者工具的Network,保留請求記錄,再按下載。找到真正回傳檔案的請求,讀Response Headers。例如: Content-Type: text/csv; charset=utf-8 Content-Disposition: attachment; filename="template-check.csv" attachment表示以附件處理,filename提供建議名稱。這份例子只提供ASCII名稱,所以中文標題不會自動出現在下載檔名。實際儲存行為仍由瀏覽器與檔案系統處理,不要把它當成可以指定訪客電腦完整路徑的指令。 若沒有這個標頭,瀏覽器可能依URL或其他條件取得名稱。先記錄目前回應,不必立刻到所有頁面加相同屬性;請維護下載程式的人核對真正送檔的入口。 中文名稱放在filename*,保留簡單備用檔名 需要非ASCII名稱時,可由回應提供filename*,使用指定字元編碼及百分比編碼。下面同時保留英文備用名稱,中文部分代表「模板檢查.csv」: Content-Disposition: attachment; filename="template-check.csv"; filename*=UTF-8''%E6%A8%A1%E6%9D%BF%E6%AA%A2%E6%9F%A5.csv UTF-8''後方是UTF-8檔名的編碼,不是把中文字隨便塞進標頭。支援這個參數的處理端會優先使用filename*;保留ASCII的filename,可讓不理解擴充寫法的處理端還有合理名稱。 注意兩個單引號的位置,也不要同時輸出兩個相同的filename*。如果使用的框架已有下載回應方法,先查它如何接收Unicode檔名與產生標頭,不要在既有設定後再手動追加一份,造成重複參數。 百分比編碼只做一次 常見失誤是先把檔名編成%E6...,再交給會自行編碼的程式。第二次把百分比符號變成%25,瀏覽器解碼一次後,仍得到一串%E6...,而非原本的中文。 可先用JavaScript查看一次編碼的結果,但實際標頭仍由下載伺服器產生: encodeURIComponent('模板檢查.csv'); // %E6%A8%A1%E6%9D%BF%E6%AA%A2%E6%9F%A5.csv 這個例子不包含撇號等需要額外處理的字元,不能把它當成完整通用的Content-Disposition產生器。正式程式應使用框架或函式庫提供的標頭編碼方法,先確認輸入要的是原始Unicode名稱,還是已編碼字串。 不要把擴充參數的寫法直接搬進普通filename。百分比編碼在filename中的處理並非所有瀏覽器一致,可能一個瀏覽器看起來正常,另一個保留原字串。可預期的ASCII備用名稱,比把同一串編碼塞進兩個欄位更容易維護。 用同一份內容,確認改的是哪一層 準備一份不含客戶資料的小檔案,做三個測試回應:只有ASCII備用名稱、filename*編碼一次、filename*重複編碼。檔案內容保持完全相同,再比較瀏覽器建議名稱與下載後的內容。 本文CSV案例的三個入口送出相同位元組;Chromium取得的名稱依序是template-check.csv、模板檢查.csv與仍帶百分比文字的名稱。這能分清標頭造成的差異,不代表所有瀏覽器都會給出相同結果。 保存下載檔後,再以同一種方式查看內容或計算雜湊。若三份內容相同,就別把名稱修正說成資料修復。反過來,如果內容也不同,回頭查是否拿到了登入頁、錯誤訊息或另一個檔案,不能只靠副檔名判斷。 別把路徑與私人資料當成檔名 檔名只需要識別文件。避免使用完整伺服器路徑、私人Email或客戶識別碼,也不要相信使用者傳入的檔名可以直接寫進標頭。保留合理副檔名,清理控制字元與路徑分隔符;下載目標仍由功能自己的資料與授權流程決定。 瀏覽器可能為配合檔案系統調整不允許的字元。同名檔案已存在時,儲存端也可能加序號。看到「模板檢查(1).csv」,先確認是否是本機已有同名檔,而不是立刻判定伺服器又多編碼一次。 修正前保存原下載回應設定和標頭,只改一個測試入口。用自己的正式支援瀏覽器重試中文、空白與ASCII名稱,確認內容、格式、檔名都正確,再擴大到其他下載功能。 如果檔名正常卻無法下載,請另查回應狀態與下載行為;如果內容開啟後亂碼,則把實際檔案交給負責內容編碼的人。這樣維護者知道應該修標頭、檔案位元組,還是下載功能本身。 參考資料 MDN:Content-Disposition RFC 6266:HTTP附件檔名與擴充參數 RFC 8187:HTTP標頭參數的字元編碼 MDN:encodeURIComponent
網站第三方腳本載入失敗:讓核心內容先能用
第三方聊天、推薦或統計腳本載入失敗,不應讓整篇文章只剩轉圈圈。訪客來讀內容,至少要能看到正文、用普通連結前往下一頁,並知道附加功能現在能不能用。 先分清哪些功能是核心,哪些只是加強。網站需要登入或付款才能完成的動作,不能用假成功提示替代;但文章閱讀、聯絡方法與基本導覽,通常可以先保留在原始HTML裡。 先看停用附加腳本後,還剩什麼 挑一個自有測試頁,記下訪客最常做的動作,例如閱讀教學、打開分類或找到聯絡方法。只阻擋準備檢查的附加腳本,再重新整理。若正文消失,或普通連結也必須等那支腳本建立,核心入口就過度依賴它。 本文的文章頁案例,正文與連結先在HTML裡,附加導覽再透過一個獨立腳本啟用。阻擋該腳本後,文章仍在、原生details仍能展開、普通連結仍能移到說明;側邊只改成「暫時無法使用」與替代入口。 附加服務失敗只影響自己的區塊,閱讀入口仍然保留。 這是可操作的文章頁範例,不是第三方產品後台。正式網站要按自己的工具和主題檢查,不能因範例保留了連結,就推成所有付款、搜尋或會員功能都有替代路徑。 把基本內容先寫在HTML 連結要有真正的href,不要只留一個onclick。按鈕用於展開或觸發動作;前往另一頁的入口則使用連結。即使附加程式沒有執行,訪客仍能辨識下一步。 <article> <h2>網站導覽說明</h2> <p>先整理主要分類與聯絡入口。</p> <a href="/guides/navigation/">閱讀完整說明</a> </article> <aside> <p id="extra-status" role="status"> 附加服務載入中,可先使用文章連結。 </p> <div id="extra-widget"></div> </aside> 範例網址要換成自己存在的頁面。不要先用CSS把所有正文隱藏,等第三方成功才移除class;這樣即使HTML已經有內容,腳本失敗仍會把文章藏住。先讓正文可讀,再逐步增加附加互動。 載入失敗與執行失敗,要各有出口 外部script資源載不回來,可以由error事件處理;載回來後初始化函式拋錯,則需要對初始化另做處理。兩者不是同一件事。script的load事件發生,不能單憑它就顯示整個服務已正常運作。 const status = document.querySelector('#extra-status'); const script = document.createElement('script'); const showFallback = () => { status.textContent = '附加服務暫時無法使用,請用文章連結。'; }; script.src = '/assets/optional-widget.js'; script.onload = () => { try { if (!window.OptionalWidget) throw new Error('missing widget'); window.OptionalWidget.mount(document.querySelector('#extra-widget')); status.textContent = '附加服務已就緒。'; } catch (error) { showFallback(); } }; script.onerror = showFallback; document.head.append(script); 這段用示例物件說明邊界,並非所有工具都叫OptionalWidget。使用真實服務時,依它的正式初始化方法和錯誤回傳調整。若初始化本身是非同步,還要處理它的Promise拒絕;同步try/catch不會自動接住稍後才發生的非同步錯誤。 回饋區寫的是附加服務狀態,不要擋住整篇文章,也不要讓每次重試都彈出全頁視窗。失敗原因留在維護紀錄;訪客需要知道的是目前可用入口與下一步,不必看到一串程式堆疊。 defer與async不是失敗備援 調整script載入方式可以影響解析與執行時機,但不會自動建立替代內容。即使加了defer,腳本404、被阻擋或初始化失敗,原本依賴它的功能仍可能不能用。...
網站重新導向串太多:追出每一步網址與狀態碼
舊文章網址最後能開啟,不代表中間沒有繞路。瀏覽器可能先從舊路徑轉到過渡頁,再轉到新文章;地址列只留下最後一個網址,兩次跳轉就被藏起來了。 排查重新導向串時,先保留每一步的 URL、狀態碼與 Location,確認哪一步還有必要。這篇用兩段 HTTP 回應示範怎麼追,不處理 canonical 的選擇,也不要求一開始修改正式主機規則。 先看第一個回應,不自動追到底 在開發者工具的 Network 勾選保留記錄,再輸入舊網址。找到第一個文件請求,檢視 Status 與 Response Headers 的 Location。接著找 Location 指向的下一個請求,重複到最後頁面。 例如舊路徑 /old-guide 回301,Location 是 /middle-guide;middle-guide 再回302,Location 是 /final-guide;final-guide 才回200。訪客要讀最後的文章,瀏覽器先做了兩次轉向。 /old-guide → 301 Location: /middle-guide /middle-guide → 302 Location: /final-guide /final-guide → 200 Location 可以是相對地址,不能只把字串貼在另一個網域上猜。按上一個回應的 URL 解析,再核對實際下一個請求。遇到跨網域、http轉https或尾斜線變更,也各自算一步,別把它們合併成「瀏覽器自己修好了」。 用 curl 儲存每一步 在 Windows 終端機可明確使用 curl.exe,避免叫到不同工具的同名指令。先用不帶 -L 的請求檢視第一個回應;-o NUL 不輸出正文,-D - 把標頭寫到畫面: curl.exe -sS -D - -o NUL "https://example.com/old-guide" Linux 或 macOS 把 NUL 換成 /dev/null。這裡仍是 GET,不是 HEAD;有些網站對 HEAD 的處理不同,拿 HEAD 的結果代替訪客實際GET可能漏掉差異。對需要登入或特殊 Cookie...
網站搬進子目錄後圖片不見:查相對URL從哪裡算
首頁圖片正常,文章搬進子目錄後卻不見了;檔名沒變,上傳的圖也還在。這時先看瀏覽器把圖片網址算成什麼。相同的 src="images/cover.svg",放在不同頁面位置,可能請求完全不同的目錄。 本文先處理相對 URL 的起點:HTML 圖片、CSS 背景與 base 元素各自從哪裡算。若完整請求路徑已經正確,才接著查檔案是否存在、權限或其他回應問題,不必第一步就修改伺服器重寫規則。 先把兩個網址並排 開啟開發者工具的 Network,重新整理頁面,找到失敗圖片。記下完整的 Request URL,再抄下 HTML 裡的 src。第一個是瀏覽器真的要拿的地址,第二個只是你寫進頁面的文字;兩者不一定長得一樣。 例如頁面是 https://example.com/guides/start/index.html,圖片寫 images/cover.svg,瀏覽器會往 /guides/start/images/cover.svg 找。若檔案實際放在網站根目錄的 /images/cover.svg,兩個位置就對不上。 在 Console 可以選到圖片後檢視: const image = document.querySelector('.article-cover'); ({ written: image.getAttribute('src'), resolved: image.src, pageBase: document.baseURI, selected: image.currentSrc }) 將 class 換成目標圖片的選擇器。getAttribute 保留原本寫法,src 顯示解析後地址;有 srcset 時,也看 currentSrc,避免查了 src,實際下載卻是另一個候選圖。數值先記錄,再到 Network 核對同一個請求。 開頭斜線與上一層,是不同選擇 images/cover.svg 從目前基準目錄往下找;../images/cover.svg 先上一層;/images/cover.svg 則從解析基準 URL 的來源(origin)根路徑開始。不要在根目錄案例成功後,直接認定它適合部署在子路徑的網站。 如果整個網站放在 https://example.com/shop/,前面加斜線的 /images/cover.svg 會從該來源的根路徑開始,不會自動保留 shop。此時若圖片位於 /shop/images/cover.svg,要依實際部署結構產生正確路徑。很多建置工具另有資產基準設定,先查自己使用的工具,別用全站字串替換猜路徑。 const base = 'https://example.com/guides/start/index.html'; new URL('images/cover.svg', base).href; // https://example.com/guides/start/images/cover.svg new URL('../images/cover.svg', base).href; // https://example.com/guides/images/cover.svg new URL('/images/cover.svg',...
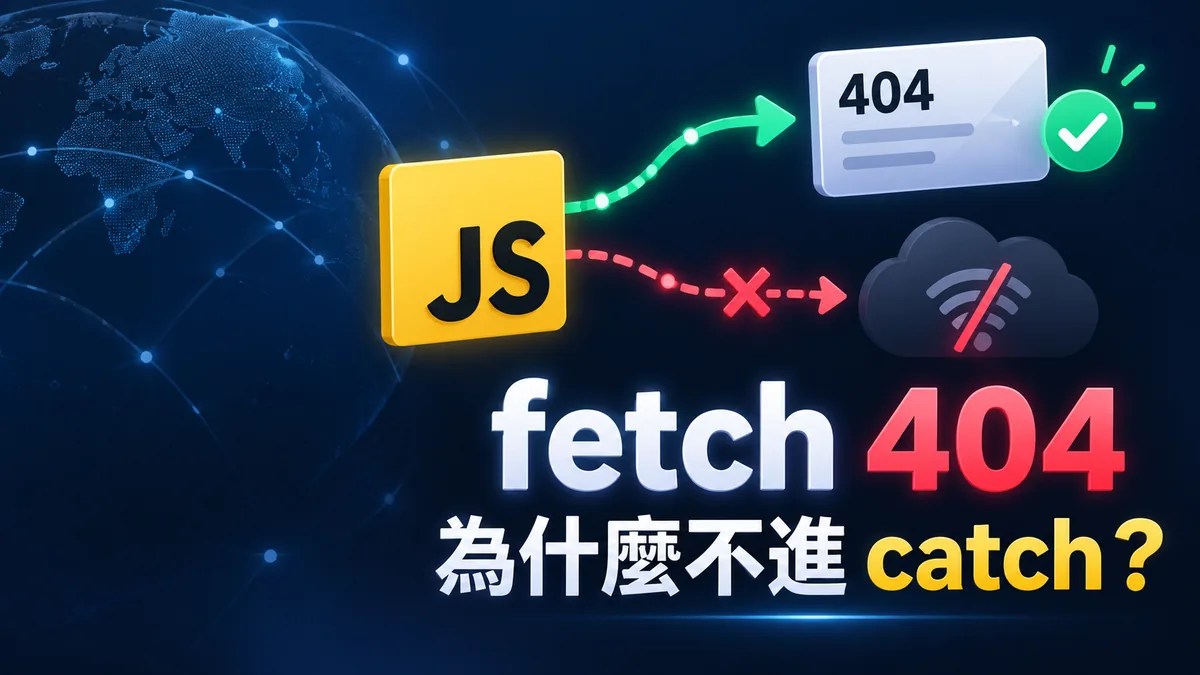
fetch拿到404為什麼不進catch?先檢查Response.ok
替網站加上作品、商品或文章卡片時,fetch已經寫了catch,API回404卻沒進錯誤處理。這不一定是catch壞了:伺服器確實回了HTTP回應,fetch的Promise通常就會完成;回應內容是不是你要的,還要再判斷。 有收到回應,和成功拿到內容分開看 404或500是HTTP回應。fetch不會只因這些狀態就自動拒絕Promise;網路連線失敗等情況才會走拒絕路徑。先讀Response.ok,它在狀態碼200到299時為true。 async function loadCards() { const response = await fetch('/api/cards'); if (!response.ok) { throw new Error(`HTTP ${response.status}`); } return await response.json(); } loadCards() .then(cards => renderCards(cards)) .catch(() => showError('內容暫時無法載入,請稍後重試。')); renderCards與showError要換成你網站真正的顯示函式。先檢查ok再讀JSON,才不會把錯誤回應當成正常卡片。即使狀態是200,JSON無法解析也可能失敗;資料能解析後,仍要確認欄位符合頁面需要。 收到同樣的404,先檢查狀態就能把失敗回應導向清楚提示。 讓訪客知道是載入失敗,不是沒有內容 網站可以分出載入中、正常空列表與失敗三種畫面。真正沒有文章時顯示「目前沒有內容」;API失敗則保留重試入口,別把它默默變成空白。訪客重新操作時,也要清掉上次的錯誤訊息。 重試不表示一定會成功。伺服器持續404時,重新請求仍會失敗;先查端點路徑與部署路由。若是登入或權限問題,也別一直自動重試,應依401、403等狀態安排適當提示。 先在自己的網站測兩種失敗 一種是端點回404,另一種是伺服器沒有可用連線。看看畫面是否都能結束載入狀態、保留主要內容與操作。範例只處理GET讀取;付款、送出資料等可能有副作用的請求,不能不分情況就重送。 參考資料 MDN:使用Fetch API MDN:Response.ok 資料核對於2026年10月3日;範例與文件可能更新。
304不是更新失敗:先分清瀏覽器快取與版本驗證
網站剛改完,你在瀏覽器的Network看到304,畫面卻好像沒變。先別把304當成錯誤,也不要馬上關掉全站快取。304表示這次條件請求被伺服器判定「版本沒有改變」,瀏覽器可以沿用已有內容;接下來要查的是,你收到的版本是否真的符合預期。 先看請求帶了什麼,再看回應 依 MDN的304說明,304常見於帶有If-None-Match或If-Modified-Since的條件式GET或HEAD請求。以ETag為例,伺服器先回傳內容與版本標記;下次瀏覽器帶回這個標記,伺服器核對後,版本相同就可回304而不重送正文。 以下例子使用同一個/notice網址,內容原本是「週一營業」,後來改成「週二營業」: 第一次GET:200,ETag: "notice-v1",正文「週一營業」 帶If-None-Match: "notice-v1"再GET:304,沒有正文 內容改版後仍帶舊ETag再GET:200,ETag: "notice-v2",正文「週二營業」 這個例子說明:304沿用的是已有的版本;內容改變且版本驗證正確時,舊標記應取得新的200回應。不是所有網站都用這些標記值,ETag生成方式由伺服器決定,也不能只看狀態碼就判定整條更新流程正常。 no-cache與no-store,別看名字猜意思 Cache-Control: no-cache不代表「完全不能保存快取」,而是保存的回應再次使用前需要向伺服器驗證,所以仍可能看到304。no-store則指示快取不要儲存這個回應;它也不是清除所有既有快取的按鈕。 若看到max-age=3600,表示符合條件的快取可在一小時的新鮮期內重用,可能根本不發出新的網路請求。因此Network顯示memory cache或disk cache,和伺服器回304是不同情況。完整規則可查 MDN的Cache-Control說明,不要為了消掉304把所有頁面一律改no-store。 改版後仍顯示舊內容,按這個順序查 先選一個有明確變動的資源,記下網址、預期文字或圖片版本。在瀏覽器開啟開發者工具的Network,重新載入,查看它的Request Headers、Response Headers與回應內容。 若是304,核對請求中的If-None-Match與回應的ETag;若有If-Modified-Since,也一併查看。要看的是版本驗證,不只是304數字。 暫時在開發者工具啟用Disable cache,再載入同一網址,觀察是否拿到預期內容;通常須保持開發者工具開啟。這是診斷瀏覽器快取,不是清除CDN或證明來源伺服器內容已更新。 若仍是舊內容,再請維護者查網站快取、反向代理或CDN,以及真正提供該資源的來源。Age、Via等標頭可能提供線索,但缺少這些標頭不能證明沒有中間快取。 測試完恢復瀏覽器的診斷設定。若需調整正式快取策略,先確認受影響頁型與回復方式;會員個人內容與公開圖片不能不加區分地共用同一套快取規則。上面的200與304例子說明單一伺服器的版本回應;你的網站若經過CDN或有會員頁,還要分別查看那些頁面實際收到的內容。 資料核對:2026年10月2日。範例版本與文字用於示範;實際網站需核對自己的請求、回應與快取層。 參考資料 MDN:304 Not Modified MDN:Cache-Control MDN:ETag MDN:If-None-Match
robots.txt封鎖了,為什麼網頁還出現在Google?
你在robots.txt加了Disallow,Google搜尋卻仍出現那個網址。先別急著把規則寫得更嚴:robots.txt控制的是爬取,並不是把網址從搜尋結果中刪除。如果你的目的是「頁面可以公開瀏覽,但不要顯示在Google」,通常要處理的是noindex,而且Google必須能讀到它。 先分清:不讓爬取,還是不讓搜尋顯示? 依 Google的robots.txt說明,即使Google不能爬取網頁,仍可能從其他頁面的連結得知網址,再把網址顯示於搜尋結果。封鎖成功與搜尋結果仍有網址,可以同時發生。 noindex則告訴支援這項規則的搜尋引擎,不要將內容編入索引。對Google來說,它需要先爬取頁面,讀到HTML的meta標記或HTTP回應標頭,才能處理這個要求。若同一網址又被robots.txt封鎖,Google就可能看不到你加的noindex。 還有一個容易混淆的需求:如果頁面含有訂單、客戶資料或內部文件,你需要的是登入驗證與權限控制。robots.txt與noindex都不是保密機制;不要為了讓Google讀到noindex,就解除敏感內容的存取保護。 用公開篩選頁看兩種設定的差別 假設網站有一個任何人都能開啟的商品篩選頁,路徑是/filter/red/。它可以供訪客使用,但你不想讓這個特定頁面出現在Google。以下是設定示例,路徑應換成你自己的頁面;不是要求把全站篩選頁一律排除。 如果robots.txt寫著: User-agent: * Disallow: /filter/red/ 同時又在該頁HTML的<head>加入: <meta name="robots" content="noindex"> 這兩項不是加倍保險。對遵守封鎖規則的Googlebot而言,它先被擋在頁面外,就無法讀到裡面的noindex。若你的目標確實是不顯示這個公開頁面,應保留noindex,並讓該網址可被爬取;調整前要核對所有匹配它的robots規則,避免只刪一行卻仍被其他規則封鎖,也不要解除不相關路徑的封鎖。 HTML頁面可採上面的meta標記;PDF等非HTML資源,也可由伺服器回應 X-Robots-Tag: noindex。這是 Google支援的兩種noindex方式。不要把Noindex:寫進robots.txt,Google不支援這種寫法。 改好設定後,怎麼知道Google真的處理了? 先檢查「設定有送出」,再檢查「Google已讀到」,最後才看搜尋結果是否改變。 用瀏覽器或HTTP工具查看目標網址的實際回應。meta應在HTML的head中;若用X-Robots-Tag,檢查的是HTTP標頭。外掛畫面勾選了noindex,不代表訪客與爬蟲收到的頁面一定如此。 有該網站Search Console權限時,使用網址檢查的即時測試,確認Google能否存取頁面,以及它收到的HTML或索引規則。這是在查當下可讀的設定,不代表Google索引已立即更新。 再看網址檢查中的索引資料與網頁索引報表,留意最近爬取時間和noindex排除狀態。Google需重新爬取才能處理新增規則,不能用自己刷新搜尋結果幾次,就判定設定無效或已永久移除。 若急需移除已顯示的網址,可查看 Google的移除資訊說明。暫時移除工具不是永久處理,仍需用適合該內容的方式控制索引或存取。敏感資料應先處理存取權限與內容暴露,再處理搜尋結果,不能只等noindex生效。 資料核對:2026年10月2日。範例說明設定邏輯,實際網址的爬取與索引狀態應以你的網站回應及Search Console資料為準。 參考資料 Google:robots.txt簡介與指南 Google:使用noindex禁止建立索引 Google:控管您在搜尋分享的內容 Google:移除網站資訊